GPT-6 Luna·Gemini 3.8 Flash 비교: 상품 옵션 추출의 비용과 정답 검산
상품 설명을 엑셀 열로 옮길 때는 판매단위부터 맞춰야 합니다. ‘12개 들어 있는 상자’와 ‘12개 주문’은 같은 수량이 아닙니다. API 단가가 싼 모델을 골랐더라도 이 둘을 섞으면 사람이 원문을 다시 읽어야 합니다.
이 글에서는 GPT-6 Luna와 Gemini 3.8 Flash를 상품 옵션 추출이라는 한 가지 업무로 비교합니다. 공식 가격과 지원 기능은 확인했지만 실제 모델에 예제를 실행하지 않았습니다. 아래 정답은 작성자가 합성 상품 설명에 대해 정한 기대값입니다. 실제 정확률이나 응답 속도 순위로 읽지 마세요. 공식 문서 재확인·자료 검산 기준일은 2026년 10월 10일 한국시간입니다. 이번 글의 유료 API 호출은 0회입니다.
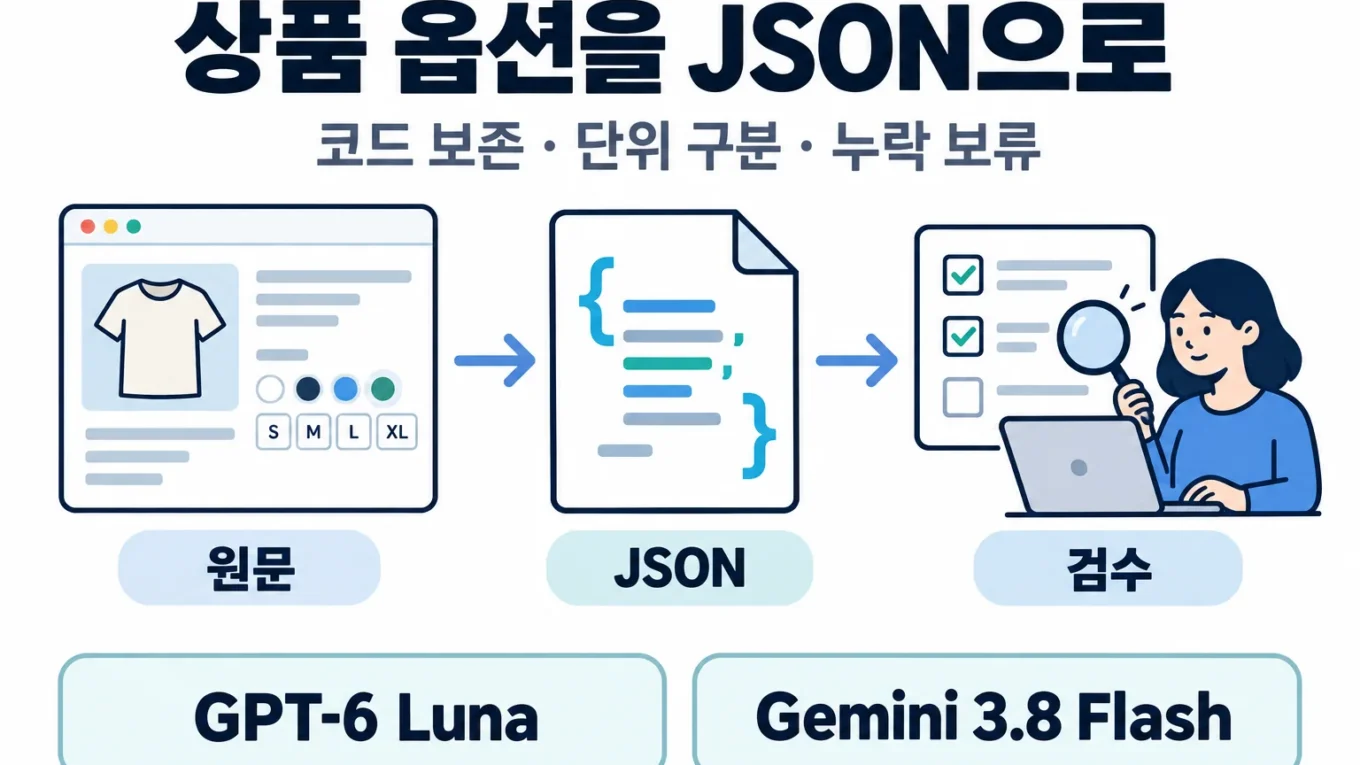
대표 이미지는 상품 원문에서 JSON을 만들고 검수하는 설명용 도해입니다. 실제 모델 응답이나 정확도 결과가 아닙니다.
먼저 비교할 조건을 고정합니다
입력은 짧은 한국어 상품 설명, 출력은 JSON입니다. 검색·이미지·파일 읽기 도구를 쓰지 않는 Standard 유료 API 요청을 기준으로 잡습니다. 웹 앱 구독료와 API 사용료는 별도입니다. 모델별로 같은 원문과 업무 규칙을 사용하되 지원하는 설정값은 각 공식 문서에 맞춥니다.
OpenAI의 실제 모델 ID는 gpt-6-luna, Google의 실제 모델 ID는 gemini-3.8-flash입니다. 양쪽 모두 구조화 출력을 지원합니다. Luna는 컨텍스트 1,050,000토큰과 최대 출력 128,000토큰을, Flash는 최대 입력 1,048,576토큰과 최대 출력 65,536토큰을 명시합니다. 컨텍스트 창과 최대 입력은 같은 이름의 지표가 아니므로 숫자만 보고 우열을 매기지 않습니다. Luna 공식 모델 문서, Flash 공식 모델 문서
Luna의 추론 수준은 none·low·medium·high·xhigh·max이고, none으로 추론을 끌 수 있습니다. Flash의 thinking 수준은 low·medium·high입니다. 두 모델의 ‘낮음’이 같은 추론량이나 속도를 뜻하지 않습니다. 비교 기록에 실제 사용한 수준을 남기세요. 이 글에는 설정별 실행 결과가 없습니다.
짧은 요청의 공식 단가
아래 가격은 미국 달러이며 토큰 100만 개당입니다. Luna는 입력 272K토큰 이하의 Standard 요율, Flash는 2026년 12월 31일까지의 Standard 소개 요율입니다. 출력에는 청구되는 추론 토큰도 빠뜨리지 않아야 합니다.
| 항목 | Luna | Flash 3.8 |
|---|---|---|
| 일반 입력 | $0.10 | $0.75 |
| 출력 | $0.50 | $3.75 |
| 캐시 입력 읽기 | $0.01 | $0.075 |
| Batch 입력 / 출력 | $0.05 / $0.25 | $0.375 / $1.875 |
Luna의 캐시 쓰기 적용 단가는 $0.125입니다. 일반 입력 $0.10에 $0.125를 더하는 방식으로 계산하지 않습니다. 입력 272K를 초과하면 전체 요청의 입력·캐시 요율이 2배, 출력은 1.5배입니다. 지역 처리 등의 추가 요금도 별도 조건입니다. Flash의 명시적 캐시 저장료는 소개 기간에 100만 토큰·시간당 $0.50입니다. implicit cache에 같은 저장료를 자동으로 붙이지 않습니다. 2027년 1월 1일부터 Flash의 Standard 입력 / 출력은 $1.50 / $7.50, 캐시 읽기는 $0.15, 저장료는 $1.00으로 바뀌는 일정이 공식 가격표에 안내돼 있습니다. OpenAI 가격표, Gemini Developer API 가격표
캐시 가격을 모든 입력에 적용해서는 안 됩니다. Luna의 최소 캐시 가능 prefix는 숨은 시스템 내용을 제외한 가시 입력 1,024토큰, Flash의 implicit cache는 4,096토큰 조건이 있습니다. 캐시 적중을 사용량에서 확인해야 합니다. Google의 Interactions API는 implicit cache만 지원하며, 캐시 객체를 직접 만드는 명시적 캐시는 generateContent API를 써야 합니다. 캐시 쓰기·저장·읽기를 한 항목으로 합치지 마세요. OpenAI 캐시 조건, Google 캐시 조건
Batch는 양쪽 모두 일반 요율의 50%를 안내하지만 비동기 작업입니다. OpenAI는 24시간 처리 창을, Google은 24시간 목표 처리 시간을 안내합니다. 만료·부분 실패를 확인해야 하며 모든 요청의 성공을 보장하는 시간으로 쓰면 안 됩니다. 즉시 답이 필요한 업무와 같은 조건으로 비교하면 안 됩니다. Google Batch는 현재 generateContent API 경로를 사용합니다. Google 가격표의 Batch 탭과 Batch 가이드에는 캐시 적중 요율 설명이 일치하지 않는 부분이 있어 두 할인을 중첩한 비용은 여기서 단정하지 않습니다. 이 글의 비용 예시는 캐시와 Batch 할인 없이 계산합니다. OpenAI Batch 문서, Google Batch 문서
두 후보의 장점과 주의점
| 후보 | 시작할 때 유리한 점 | 확인할 점 |
|---|---|---|
| GPT-6 Luna | 이 비교의 짧은 Standard 요청에서 기본 입출력 단가가 낮습니다. none 설정으로 추론을 끈 조건도 기록할 수 있습니다. | 단가만으로 판매단위 추출 품질을 알 수 없습니다. 장문 할증과 캐시 쓰기 조건을 별도로 봅니다. |
| Gemini 3.8 Flash | 기존 Gemini 연동을 유지하면서 같은 JSON 실습을 비교할 수 있습니다. | 소개 요금 종료일을 확인합니다. Interactions와 generateContent의 캐시·Batch 지원을 혼합하지 않습니다. |
두 모델 모두 출력 형식을 지정할 수 있지만, 형식 준수가 상품값의 정답을 보장하지는 않습니다. 최종 선택은 아래 기대값과 첫 응답을 대조한 다음 결정합니다.
판매단위와 주문 수량을 구별하는 8행
다음 입력은 모두 가상 상품입니다. 코드의 앞자리 0과 하이픈은 문자 그대로 보존합니다. pieces_per_sale는 가격이 붙은 판매단위 하나에 들어 있는 낱개 펜 수입니다. 주문 수량이나 무료배송 조건을 이 값에 섞지 않습니다.
P01 | 00127 검정 펜 12개/상자, 상자당 6,000원.
P02 | 00128 파랑 펜 1개 단위 판매, 개당 600원. 주문 수량은 12개.
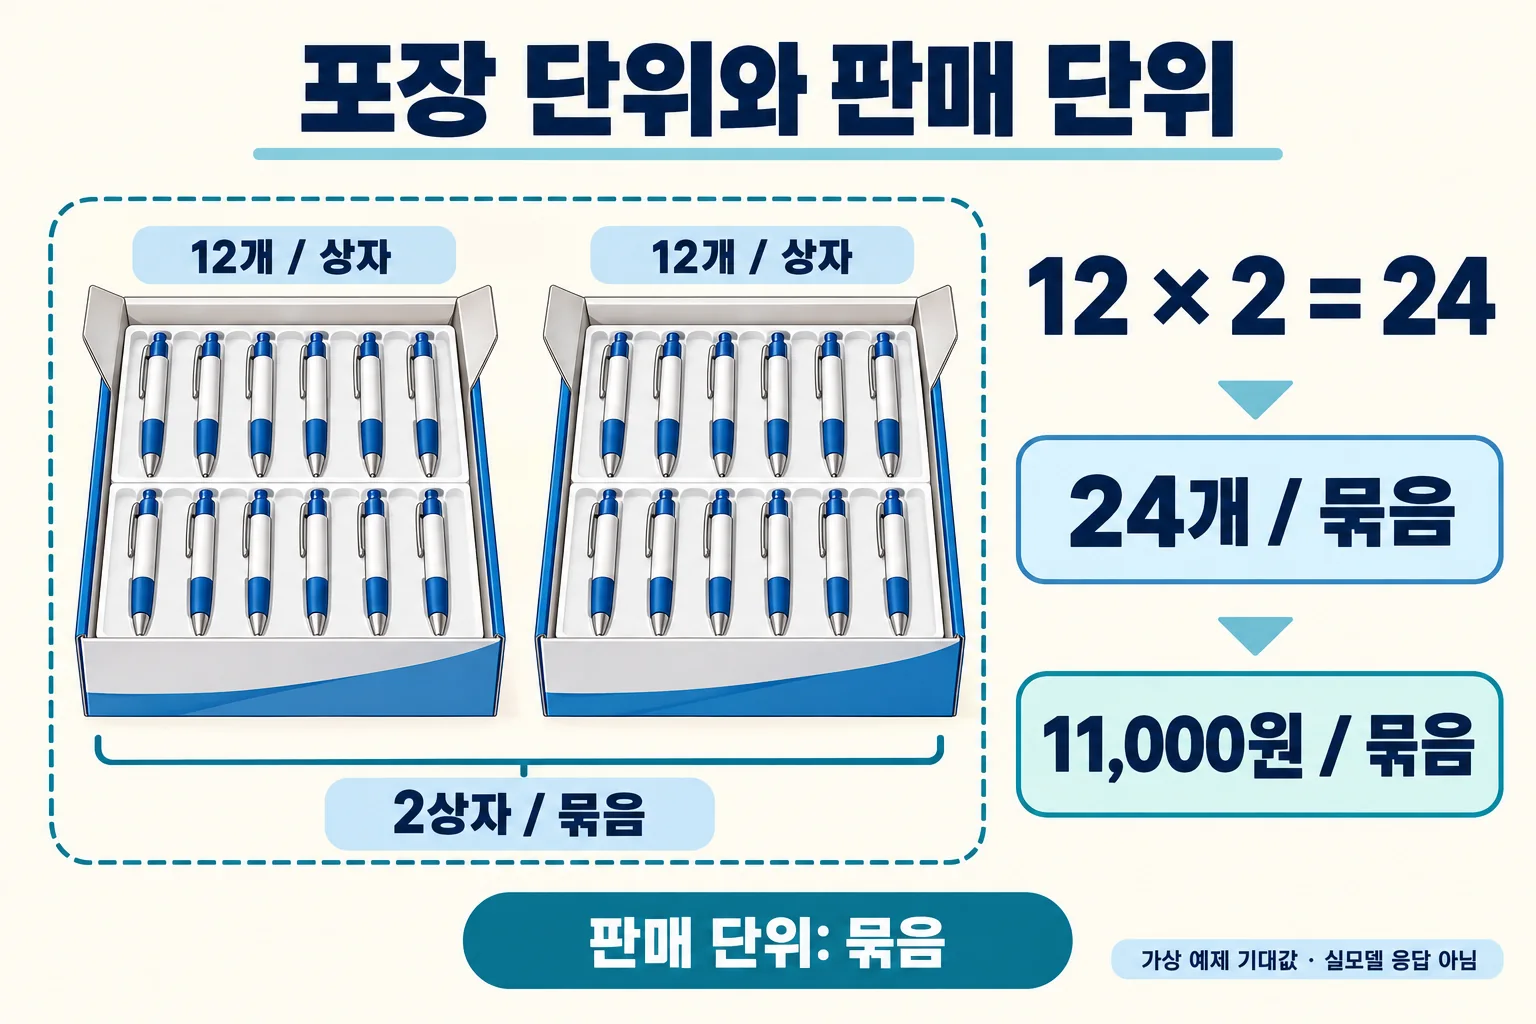
P03 | 00129 검정 펜 12개/상자, 2상자 묶음 11,000원.
P04 | 00130 빨강 펜 12개/상자, 가격 미정.
P05 | 00131 초록 펜 봉당 2,500원. 한 봉에 몇 개가 들어 있는지는 미기재.
P06 | A-0132 검정 펜 10개/상자, 상자당 5,000원.
P07 | 00133 파랑 펜 12개/상자. 정상가는 7,000원, 이번 견적의 상자당 단가는 6,300원.
P08 | 00134 흰색 펜 8개/봉, 봉당 3,200원. 3봉 이상 구매 시 무료배송.
두 모델에 줄 공통 요청문
각 상품을 items 배열의 JSON 객체로 옮겨 주세요.
필드는 id, sku, color, sale_unit, pieces_per_sale,
sale_price_krw, status, evidence 여덟 개만 사용합니다.
sku는 원문 그대로인 문자열입니다.
sale_unit은 가격이 붙은 판매단위입니다.
pieces_per_sale는 그 판매단위 하나에 들어 있는 낱개 펜 수입니다.
sale_price_krw는 이번 견적에 적용되는 판매단위당 가격입니다.
주문 수량과 무료배송 조건은 포장 개수로 쓰지 않습니다.
없는 개수나 가격은 null로 두고 status를 hold로 기록합니다.
필수 값이 모두 확인되면 status는 ready입니다.
evidence에는 판단 근거가 되는 원문의 연속된 문장을 그대로 넣습니다.
원문에 없는 단위나 가격을 추측하지 마세요.
합계, 낱개 환산 가격, 추가 설명 필드는 만들지 않습니다.
프롬프트에 JSON을 요청하는 것과 API의 구조화 출력 설정을 지정하는 것은 다른 단계입니다. 실제 구현에서는 모델이 지원하는 JSON Schema로 형식을 지정하고 응답도 검증해야 합니다. 두 회사 모두 지원하는 스키마 범위에 제한이 있습니다. 스키마에 맞는 응답에도 잘못된 업무값이 들어갈 수 있습니다. OpenAI 구조화 출력, Google 구조화 출력
정답과 비교할 항목
- P01: 코드 00127, 검정, 상자, 12개, 6,000원, ready
- P02: 코드 00128, 파랑, 개, 1개, 600원, ready. 주문한 12개를 포장 개수로 넣지 않습니다.
- P03: 코드 00129, 검정, 묶음, 24개, 11,000원, ready. 12개 × 2상자이며 상자당 가격으로 바꾸지 않습니다.
- P04: 코드 00130, 빨강, 상자, 12개, 가격 null, hold
- P05: 코드 00131, 초록, 봉, 개수 null, 2,500원, hold
- P06: 코드 A-0132, 검정, 상자, 10개, 5,000원, ready
- P07: 코드 00133, 파랑, 상자, 12개, 6,300원, ready. 정상가 7,000원을 이번 견적값으로 쓰지 않습니다.
- P08: 코드 00134, 흰색, 봉, 8개, 3,200원, ready. 무료배송의 3봉을 곱하지 않습니다.
기대 상태는 ready 6행, hold 2행입니다. hold를 정확히 남긴 응답도 이 실험의 정답입니다. 모든 행을 ready로 만드는 비율을 성공률로 삼으면 모르는 값을 채우는 모델에 유리해집니다.
검수는 ID 8개가 한 번씩 있는지, SKU가 문자로 보존됐는지, 숫자 필드가 숫자 또는 null인지부터 확인합니다. 이어서 판매단위·낱개 수·견적 단가를 행별로 대조하고 근거 문장이 실제 원문에 있는지 읽습니다. P02의 개수를 12로 바꾼 JSON도 형식 검사는 통과할 수 있으므로 원문 대조를 건너뛰지 않습니다.
실습 파일로 직접 검산하기
실습 ZIP은 12개 파일, 9,470바이트입니다. SHA-256: cbc7861525318ad305bdea9555342f46956c0634824f9fb842ba0f57ea7f6a10
ZIP에는 합성 원문, 공통 요청, 기대 JSON, 출력 계약, 오프라인 검사기, 빈 실행기록 CSV, 공식 출처와 설명서가 있습니다. API 키·개인정보·매크로·모델 자동 호출 기능은 없습니다. 기대 답은 모델에 미리 보여주지 않습니다.
- ZIP 전체를 빈 폴더에 풀고 Python 3에서
python3 verify.py를 실행합니다. 기대 답 검사와 반례 15건의 거절 검사가 통과해야 합니다. - 모델의 원본 응답을 고치지 않고
response.json으로 저장한 뒤python3 verify.py response.json을 실행합니다. 불일치는 종료 코드 1로 표시합니다. - 자동검사는 키·자료형·ID·고정 업무값과 원문 문자열 포함을 검사합니다. ‘펜’처럼 원문에 있지만 판단을 뒷받침하지 못하는 근거도 문자열 검사만으로는 통과할 수 있습니다. 모든 근거가 단위·수량·가격·보류 결정을 실제로 뒷받침하는지는 사람이 원문과 대조합니다.
- 첫 응답과 수정 응답을 나누어 기록합니다. 실행하지 않은 칸은 비워 둡니다. 자동검사 통과 문구를 전체 업무 검수 완료나 모델 정확도 점수로 바꾸지 않습니다.
검사기는 이 여덟 합성 상품의 고정 기준만 다루며 모든 JSON Schema나 자연어 의미를 판정하는 프로그램은 아닙니다. Python 표준 라이브러리만 사용하고 입력·응답 파일을 덮어쓰지 않습니다.
재시도 비용까지 계산합니다
가령 한 요청의 입력을 1,000토큰, 청구 대상 출력을 500토큰으로 가정하면 Luna는 $0.00035, Flash는 $0.002625입니다. 같은 가상 요청 1,000회는 각각 $0.35와 $2.625입니다. 이는 위 8행 프롬프트의 실측 토큰 수가 아닙니다. 두 모델이 같은 토큰 수를 쓴다는 예측도 아닙니다. 실제 비용은 각 모델의 토크나이저·응답 길이·추론·할인 적중에 따라 달라집니다.
실제 선택에는 모델별·동일 설정별로 ‘모든 최초 요청과 재시도의 API 비용 합계 ÷ 검수를 통과한 고유 상품 행 수’를 따로 기록하세요. 기대값대로 hold를 남긴 행도 근거 검수를 통과하면 분모에 포함합니다. 두 모델의 비용과 같은 상품 ID를 한 합계로 섞지 않습니다. 실패·거절·잘림·재시도도 비용 합계에서 빼지 않습니다. 같은 행이 두 번 통과해도 분모에는 한 번만 넣습니다. 사람이 검토한 시간과 비용은 API 요금과 별도 열에 남깁니다. 통과 행이 0개면 유효 결과당 비용을 0원으로 기록하지 말고 계산 불가로 둡니다.
이 글에는 모델별 실패율을 가정한 승자 표가 없습니다. 단가의 차이는 확인할 수 있지만 재시도율과 검수 시간의 차이는 실제 업무 표본으로 측정해야 합니다.
오류가 나면 어디서 복구할까요
- JSON 형식 오류나 응답 잘림: 원본 응답과 사용량을 남깁니다. 지원 스키마와 완료 상태를 확인하고 출력 한도나 입력 묶음 크기를 조정합니다. 수정한 실험은 최초 시도와 별도로 기록합니다.
- 수량 단위 오류: P02·P03·P08을 먼저 대조합니다. 판매단위와 주문 수량의 정의를 분명히 고치고 같은 정답으로 다시 검사합니다.
- 미정값 추측: P04·P05를 사람이 보류합니다. 상품 원본이나 담당자 확인으로 누락 정보를 보완한 뒤 처리합니다. 비싼 모델로 바꿔도 원문에 없는 정보가 생기지는 않습니다.
- 인증·권한·한도 오류: 내용 평가와 분리해 기록합니다. 계정 설정이나 결제부터 임의로 바꾸지 않습니다.
업무 조건에 맞게 고르는 방법
짧은 설명을 반복해서 옮기고 검수 규칙을 자동으로 적용할 수 있는 업무라면 Luna를 작은 표본의 시작 후보로 둘 수 있습니다. 이유는 이 조건의 공식 단가가 낮기 때문입니다. 이것이 상품 추출 정확도가 더 높다는 뜻은 아닙니다.
이미 Gemini API로 원본과 응답을 관리하는 업무라면 Flash도 같은 8행으로 확인하세요. 기존 연동 유지에 드는 시간까지 비용에 포함하면 단가표만으로는 드러나지 않는 차이를 볼 수 있습니다. 이미지·PDF 추출을 추가하면 다른 실험이 되므로 이 글의 결과와 분리합니다.
복잡한 세트 구성이나 미정 견적은 모델 선택 전에 업무 규칙과 원본을 보완해야 합니다. 어느 모델을 쓰든 판매단위 하나와 가격 하나가 대응하는지 확인한 다음 승인된 값만 엑셀에 반영하세요.
업무별 모델의 전체 선택 기준은 GPT·Claude·Gemini 5종 비교를, 문의 JSON의 형식 계약은 업무용 AI JSON 계약을 참고하세요. 이번 글은 상품 판매단위와 견적값을 확인하는 별도 실습입니다.
작성자 소개
