사진 속 표를 AI로 옮길 때 병합 셀과 누락 행 확인하기
사진 속 표를 AI로 옮겼다면 합계뿐 아니라 원본의 각 줄과 비교하세요. 한 줄이 빠지고 다른 줄의 금액이 늘어나면 합계가 같아도 틀린 표가 됩니다. 여러 칸을 하나로 합친 병합 셀과 원래 내용이 없는 빈칸도 구분해야 합니다. 이 글에서는 가상 영수증 표를 예로 들어 줄이 빠지지 않았는지, 각 행의 값과 금액이 정확한 줄에 들어갔는지 확인합니다.
본문의 가상 영수증 표와 잘못 옮긴 표는 직접 만든 설명용 자료입니다. 실제 사진을 입력받거나 사진 속 글자를 읽는 OCR·AI 서비스를 실행한 시험은 아닙니다. 사진 파일이나 다운로드 없이 본문의 표·좌표 규격·검사 코드로 대조할 수 있습니다.
먼저 확인할 입력과 도구의 범위
OpenAI Image inputs 안내는 이미지와 함께 무엇을 봐야 하고 어떤 결과가 필요한지 설명하도록 안내합니다. 사진에 표가 여러 개 있다면 대상 표, 행 범위, 출력 열을 먼저 지정합니다. 실제로 읽을 수 없는 영역은 추측해서 채우지 않습니다.
Microsoft의 Data from Picture 안내도 분석 결과를 검토하고 필요한 수정을 한 뒤 삽입하도록 안내합니다. 지원 플랫폼·문자 집합은 해당 문서에서 확인해야 하며, 확인한 지원 문자 목록에 한국어가 없으므로 이 기능이 한국어 표를 지원한다고 일반화하지 않습니다.
이 글은 Excel의 사진 가져오기 메뉴를 재현하거나 두 제품의 인식 성능을 비교하지 않습니다. 어떤 경로로 옮겼든 결과에 적용할 구조 검토를 다룹니다. 원본 사진의 파일·내용을 바꾸지 말고, 읽기 쉬운 별도 사본이 필요할 때도 원본과 사본을 구분해 둡니다.
완전한 가상 원본 표와 병합 규칙
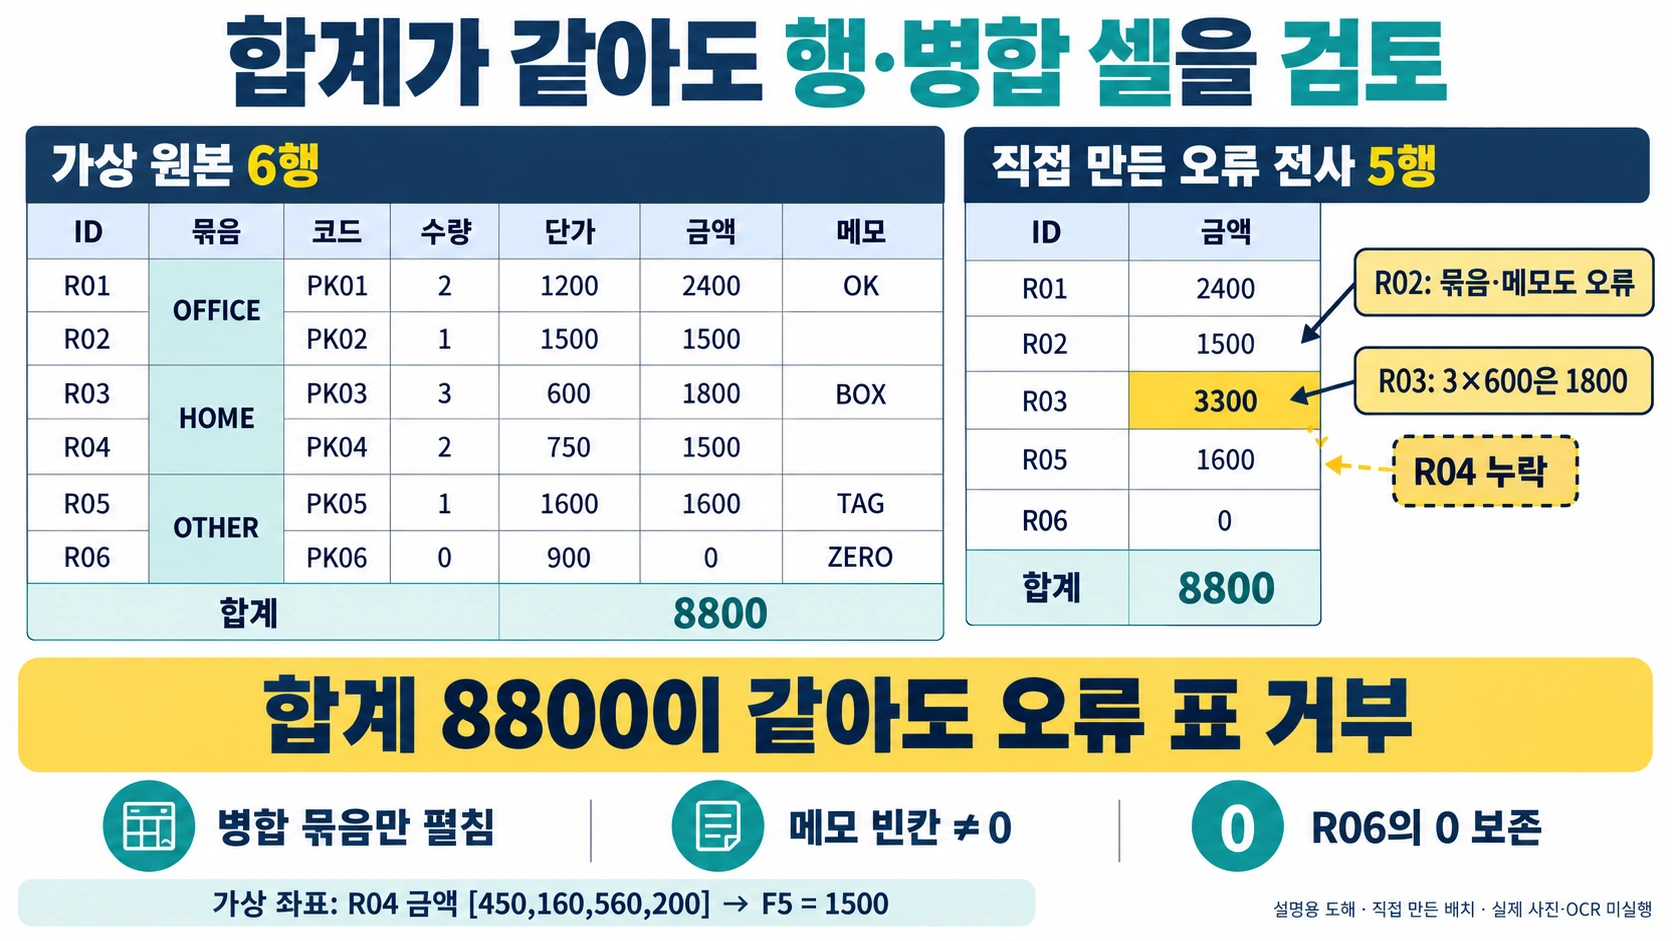
단위는 수량 개, 단가·금액 원입니다. 여섯 상세 행과 별도 합계 행이 있습니다. 행 ID도 이 가상 원본에 포함된 값이며 실제 거래가 아닙니다. OFFICE·HOME·OTHER는 가상의 묶음 이름입니다.
| 원본 행 ID | 묶음 | 제품 코드 | 수량 | 단가 | 금액 | 메모 |
|---|---|---|---|---|---|---|
| R01 | OFFICE | PK01 | 2 | 1200 | 2400 | OK |
| R02 | R01과 병합 | PK02 | 1 | 1500 | 1500 | 빈칸 |
| R03 | HOME | PK03 | 3 | 600 | 1800 | BOX |
| R04 | R03과 병합 | PK04 | 2 | 750 | 1500 | 빈칸 |
| R05 | OTHER | PK05 | 1 | 1600 | 1600 | TAG |
| R06 | R05와 병합 | PK06 | 0 | 900 | 0 | ZERO |
| 합계 | 해당 없음 | 해당 없음 | 해당 없음 | 해당 없음 | 8800 | 해당 없음 |
표의 ‘R01과 병합’ 등은 배치를 설명하는 표기이며 실제 셀 문자열이 아닙니다. 원본 묶음 칸은 R01:R02, R03:R04, R05:R06의 세 영역으로 각각 병합되어 있습니다. 대표 셀의 값은 OFFICE, HOME, OTHER이고, 아래쪽 행에 같은 글자가 별도로 있는 것은 아닙니다.
반면 R02와 R04의 메모는 실제 빈칸입니다. 위쪽 OK나 BOX가 아래 행에 이어진다는 근거가 없습니다. R06의 수량 0과 금액 0은 숫자가 있는 셀이므로 빈칸으로 바꾸거나 행 자체를 빼지 않습니다.
원본 상세 금액은 2400 + 1500 + 1800 + 1500 + 1600 + 0 = 8800입니다. 이번 가상 표는 각 행에서 수량×단가=금액입니다. 실제 영수증에 할인·세금·반올림이 별도로 있다면 먼저 그 규칙을 확인하고, 이 곱셈 규칙을 그대로 적용하지 않습니다.
사진 영역과 셀을 연결하는 좌표 규격
실제 사진이 없으므로 아래 좌표는 측정값이 아니라 가상 표의 완전한 배치 규격입니다. 700×320 크기의 사각형에 표가 채워진다고 가정합니다. 왼쪽 위를 (0,0)으로 두고 x는 오른쪽, y는 아래로 증가합니다. 영역은 [왼쪽, 위, 오른쪽, 아래]로 쓰며 오른쪽·아래 경계는 다음 셀의 시작입니다.
가상 표 크기: 가로 700, 세로 320
열 순서: id, group, code, qty, unit, amount, note
열 경계 x: 0, 60, 160, 260, 340, 450, 560, 700
머리글 y: 0~40
R01 y: 40~80
R02 y: 80~120
R03 y: 120~160
R04 y: 160~200
R05 y: 200~240
R06 y: 240~280
합계 y: 280~320
병합 묶음 OFFICE: [60, 40, 160, 120]
병합 묶음 HOME: [60, 120, 160, 200]
병합 묶음 OTHER: [60, 200, 160, 280]
옮긴 표는 A:G 열에 id·group·code·qty·unit·amount·note를 놓고, 1행을 머리글로 두어 R01:R06을 2:7행에 대응시킵니다. 원본 병합 영역은 한 개지만 분석용 결과는 행마다 한 레코드가 되도록 묶음 값을 펼칩니다. 원본의 병합 구조와 펼친 결과를 같은 상태라고 적지 않습니다.
| 원본 위치·상태 | 가상 원본 영역 | 옮긴 셀 | 확인할 값과 근거 |
|---|---|---|---|
| R01:R02 묶음 병합 | [60,40,160,120] | B2·B3 | OFFICE, 병합 대표 값에서 펼침 |
| R03:R04 묶음 병합 | [60,120,160,200] | B4·B5 | HOME, 병합 대표 값에서 펼침 |
| R05:R06 묶음 병합 | [60,200,160,280] | B6·B7 | OTHER, 병합 대표 값에서 펼침 |
| R02 메모 빈칸 | [560,80,700,120] | G3 | 빈칸 유지, OK를 채우지 않음 |
| R04 메모 빈칸 | [560,160,700,200] | G5 | 빈칸 유지, BOX를 채우지 않음 |
| R04 금액 | [450,160,560,200] | F5 | 1500, 누락 시 원본 행에서 확인 |
| R06 수량·금액 | [260,240,340,280] / [450,240,560,280] | D7·F7 | 두 셀 모두 숫자 0 |
| 합계 금액 | [450,280,560,320] | F8 | 원본 표시값 8800, 상세 합계와 별도 대조 |
자신의 사진에서는 크기·회전·잘림 여부를 확인한 뒤 새 좌표를 기록합니다. 이미지를 잘랐다면 원본 기준 좌표인지 잘린 사본 기준 좌표인지 표시합니다. 여기의 700×320 규격을 실제 사진에서 관찰한 영역처럼 옮겨 쓰지 않습니다.
합계 8800인데도 실패하는 오류 전사
아래 오류 표는 직접 작성했습니다. R04를 빠뜨리는 대신 R03 금액에 1500을 더해 총액이 우연히 같도록 만들었습니다. R02의 묶음과 빈 메모도 바꿨습니다. 실제 OCR 결과라고 소개하지 않습니다.
| ID | 묶음 | 코드 | 수량 | 단가 | 금액 | 메모 |
|---|---|---|---|---|---|---|
| R01 | OFFICE | PK01 | 2 | 1200 | 2400 | OK |
| R02 | HOME | PK02 | 1 | 1500 | 1500 | 0 |
| R03 | HOME | PK03 | 3 | 600 | 3300 | BOX |
| R05 | OTHER | PK05 | 1 | 1600 | 1600 | TAG |
| R06 | 병합 종속 빈칸 | PK06 | 0 | 900 | 0 | ZERO |
이 오류 표의 합계도 8800입니다. 그러나 상세 행은 다섯 개이고 R04가 없으며, R03의 3×600은 1800이지 3300이 아닙니다. R02의 묶음은 원본 병합 영역과 다르고, 메모의 0도 원본에 없던 문자입니다. ‘합계 일치’와 ‘원본 구조·내용 일치’를 따로 판정해야 합니다.
행 번호가 없는 실제 사진에서는 위에서 아래로 임시 행 ID를 붙이고 원본의 위치를 보관합니다. 숫자 0인 행, 공백이 많은 행, 병합된 행도 상세 행 수에 포함되는지 직접 확인합니다. 한 열의 값만 세면 빈칸 때문에 행 수를 잘못 계산할 수 있습니다.
병합 범위만 펼치고 빈 메모는 남기는 전체 검사
아래 코드를 photo_table_check.py로 저장합니다. 원본 SOURCE와 오류 BAD를 모두 담았으며 Python 3의 표준 라이브러리만 사용합니다. 로컬 문자열·숫자·가상 좌표 검사이고 사진 읽기, 파일 수정, 실제 셀 입력 기능은 없습니다.
import json
from collections import Counter

COLUMNS = ["id", "group", "code", "qty", "unit", "amount", "note"]
SOURCE = [
    ["R01", "OFFICE", "PK01", 2, 1200, 2400, "OK"],
    ["R02", "", "PK02", 1, 1500, 1500, ""],
    ["R03", "HOME", "PK03", 3, 600, 1800, "BOX"],
    ["R04", "", "PK04", 2, 750, 1500, ""],
    ["R05", "OTHER", "PK05", 1, 1600, 1600, "TAG"],
    ["R06", "", "PK06", 0, 900, 0, "ZERO"],
]
MERGE_OWNER = {"R02": "R01", "R04": "R03", "R06": "R05"}
TOTAL = 8800
X = [0, 60, 160, 260, 340, 450, 560, 700]
Y_DATA_START, ROW_HEIGHT = 40, 40

# Written error fixture, not an OCR or AI response.
BAD = [
    ["R01", "OFFICE", "PK01", 2, 1200, 2400, "OK"],
    ["R02", "HOME", "PK02", 1, 1500, 1500, "0"],
    ["R03", "HOME", "PK03", 3, 600, 3300, "BOX"],
    ["R05", "OTHER", "PK05", 1, 1600, 1600, "TAG"],
    ["R06", "", "PK06", 0, 900, 0, "ZERO"],
]

def expanded(rows):
    index = {row[0]: row for row in rows}
    output = []
    for row in rows:
        copied = row.copy()
        if copied[1] == "" and copied[0] in MERGE_OWNER:
            copied[1] = index[MERGE_OWNER[copied[0]]][1]
        output.append(copied)
    return output

def check(rows):
    invalid_widths = [i + 1 for i, row in enumerate(rows)
                      if not isinstance(row, list) or len(row) != len(COLUMNS)]
    if invalid_widths:
        return {"accepted": False, "input_errors": {
            "seven_column_rows_required": invalid_widths}}
    counts = Counter(row[0] for row in rows)
    expected = {row[0]: row for row in expanded(SOURCE)}
    actual = expanded(rows)
    missing = sorted(set(expected) - set(counts))
    extra = sorted(set(counts) - set(expected))
    duplicates = sorted(key for key, count in counts.items() if count > 1)
    differences = []
    arithmetic = []
    for row in actual:
        if row[0] in expected:
            for column, wanted, value in zip(COLUMNS, expected[row[0]], row):
                if wanted != value:
                    differences.append(row[0] + ":" + column)
        if row[3] * row[4] != row[5]:
            arithmetic.append(row[0])
    total_equal = sum(row[5] for row in actual) == TOTAL
    accepted = not (missing or extra or duplicates or differences or arithmetic)
    accepted = accepted and total_equal
    return {"missing": missing, "extra": extra, "duplicates": duplicates,
            "field_differences": differences, "arithmetic_errors": arithmetic,
            "total_equal": total_equal, "accepted": accepted}

def rectangle(row_id, column):
    row_index = next(i for i, row in enumerate(SOURCE) if row[0] == row_id)
    col_index = COLUMNS.index(column)
    top = Y_DATA_START + ROW_HEIGHT * row_index
    return [X[col_index], top, X[col_index + 1], top + ROW_HEIGHT]

original_copy = [row.copy() for row in SOURCE]
good = check(SOURCE)
bad = check(BAD)
duplicate = check(SOURCE + [SOURCE[1].copy()])
assert good["accepted"] is True
assert bad["total_equal"] is True and bad["accepted"] is False
assert bad["missing"] == ["R04"]
assert bad["field_differences"] == ["R02:group", "R02:note", "R03:amount"]
assert bad["arithmetic_errors"] == ["R03"]
assert duplicate["duplicates"] == ["R02"] and not duplicate["accepted"]
assert expanded(SOURCE)[1][6] == ""
assert expanded(SOURCE)[5][3] == 0
assert rectangle("R04", "amount") == [450, 160, 560, 200]
assert SOURCE == original_copy
print(json.dumps({"source_rows": 6, "source_total": TOTAL,
                  "correct_table_accepted": good["accepted"], "bad_table": bad,
                  "duplicate_rows_rejected": duplicate["duplicates"],
                  "source_preserved": True, "actual_ocr_requests": 0,
                  "result": "PASS"}, ensure_ascii=False))
python photo_table_check.py를 실행한 출력입니다.
{"source_rows": 6, "source_total": 8800, "correct_table_accepted": true, "bad_table": {"missing": ["R04"], "extra": [], "duplicates": [], "field_differences": ["R02:group", "R02:note", "R03:amount"], "arithmetic_errors": ["R03"], "total_equal": true, "accepted": false}, "duplicate_rows_rejected": ["R02"], "source_preserved": true, "actual_ocr_requests": 0, "result": "PASS"}정상 표는 승인 조건에 맞고, 오류 표는 합계가 같아도 누락 R04·R02 묶음/메모·R03 금액/행 산술 때문에 거부되었습니다. R02 중복 행도 별도 사례에서 거부했습니다. 병합 펼치기는 원본을 바꾸지 않았고 R02 메모 빈칸과 R06 수량 0도 보존되었습니다.
이 프로그램은 본문의 고정 7열·정수 입력에 맞춘 검사입니다. 임의의 OCR 텍스트를 읽는 범용 도구가 아닙니다. 실제 결과에 열 수 차이, 읽을 수 없는 숫자, 병합 대표 행의 누락이 있으면 먼저 미확인으로 분리합니다. 형식을 억지로 맞춰 검사를 실행시키지 않습니다.
끝의 빈 메모가 빠져도 열 수 오류로 거절하기
R02의 메모는 빈 문자열이지만 일곱 번째 칸 자체가 있어야 합니다. 기존 zip 비교는 짧은 쪽에서 멈추므로 R02의 마지막 빈 메모 칸을 빼거나 여덟 번째 칸을 덧붙여도 나머지 값·합계가 같으면 통과하는 사각지대가 있었습니다. 위 check는 병합 펼치기와 값 비교 전에 모든 행이 7칸 목록인지 먼저 확인합니다. 열 수가 다르면 accepted=False와 input_errors를 반환하고 계산을 중단합니다. Python zip 문서도 기본 동작이 짧은 입력에서 끝난다고 설명합니다.
같은 파일 맨 아래에 다음 반례를 덧붙여 실행합니다. 오류 위치 2는 머리글을 제외한 입력 목록의 두 번째 행이며 이 예제에서는 R02입니다. 실제 사진의 좌표나 Excel 행 번호를 뜻하지 않습니다.
missing_note = [row.copy() for row in SOURCE]
missing_note[1].pop()
extra_column = [row.copy() for row in SOURCE]
extra_column[1].append("unexpected")
for label, rows in [("missing_note", missing_note),
                    ("extra_column", extra_column)]:
    result = check(rows)
    assert result["accepted"] is False
    assert result["input_errors"]["seven_column_rows_required"] == [2]
    print(label, result)
missing_note {'accepted': False, 'input_errors': {'seven_column_rows_required': [2]}}
extra_column {'accepted': False, 'input_errors': {'seven_column_rows_required': [2]}}2026년 10월 8일 KST에 두 열 수 반례와 기존 정상·오류 전사·중복 검사를 다시 실행했습니다. 기존 출력은 유지되고 두 형식 오류는 값 비교 전에 거절됩니다. 빈 메모 칸을 복구할 때는 원본이 실제 빈칸임을 확인한 경우에만 빈 문자열을 넣습니다. 추가 칸은 어떤 열이 잘못 분리됐는지 원본과 대조하며 임의로 잘라 버리지 않습니다. 이 보완은 열 수 검사이며 판독 불가 숫자·잘못된 자료형·병합 대표 행 누락을 자동 복구하는 기능은 아닙니다.
오류를 복구할 때 원본이 아닌 전사 사본을 고치기
- 수정 전 오류 전사를 보관합니다
- R04 원본 영역에서 네 번째 상세 행을 다시 확인해 되살립니다
- R03 금액을 원본 1800과 대조해 수정하고 행 산술도 재확인합니다
- R02 묶음은 병합 대표 OFFICE에서 펼치되 메모는 빈칸으로 유지합니다
- 모든 상세 행과 합계를 다시 대조하고 수정 근거를 남깁니다
금액이 흐려 읽히지 않는 실제 자료라면 ‘합계에 맞추려면 1500일 것’이라고 역산해 확정하지 않습니다. 사람이 원본을 다시 확인하거나 더 읽기 쉬운 권한 있는 자료를 확보해야 합니다. 행별 산술과 합계는 이상을 찾는 단서이지 읽히지 않는 값을 발명하는 근거가 아닙니다.
그대로 복사할 대응·검토 기록
기록 ID:
원본 이름·버전·확인 날짜:
실제 사진 제공 여부와 읽은 범위:
원본 크기와 좌표 기준:
원본 행 ID·열 이름:
원본 영역 (왼쪽, 위, 오른쪽, 아래):
병합 여부·병합 대표 셀·포함 행:
원본에 보이는 값:
빈칸 상태: 실제 빈칸 / 병합 종속 / 판독 불가 / 해당 없음
수정 전 추출값과 대응 셀:
확인한 수정값과 대응 셀:
누락·중복 행:
행별 수량×단가와 금액 대조:
원본 표시 합계와 추출 합계:
확인자·근거·미확인 범위:
AI에 요청할 때도 읽힌 값과 펼친 값을 분리하도록 요구합니다. 다음은 실제 사진을 보내지 않은 요청 양식입니다.
대상 표와 행 범위: [확인한 사진·영역]
출력 열: 행 ID, 묶음, 제품 코드, 수량, 단가, 금액, 메모
원본 위치와 출력 셀의 대응을 남겨 주세요.
병합 대표 셀과 포함 행을 먼저 표시하고, 승인된 병합 범위만 행별로 펼쳐 주세요.
실제 빈칸·병합 종속 칸·판독 불가를 나눠 기록하세요.
0수량 행도 빼지 말고 합계 행은 상세 행과 분리하세요.
수량×단가와 금액 대조는 원본 계산 규칙이 확인된 경우에만 하세요.
읽히지 않는 숫자를 합계에 맞춰 만들지 마세요.
원본 사진을 변경하거나 결과를 외부로 보내지 마세요.
공식 안내와 로컬 검사 확인일은 2026년 10월 4일 KST입니다. 검사 코드는 Linux의 Python 3.12.14에서 실행했습니다. 완전한 가상 표를 대조한 결과이며 실제 사진의 읽기 정확성, 좌표 검출, Excel 입력 성공을 시험한 것이 아닙니다.
PDF의 텍스트 유무를 판단해야 한다면 스캔 PDF 입력 조건 확인 안내를 먼저 확인하세요. 이 글의 대응표는 사진 표의 구조 검토를 위한 것이며 PDF의 텍스트 층 유무를 대신 판단하지 않습니다.
작성자 소개
