AI가 스캔 PDF를 못 읽을 때 텍스트 유무 확인하기
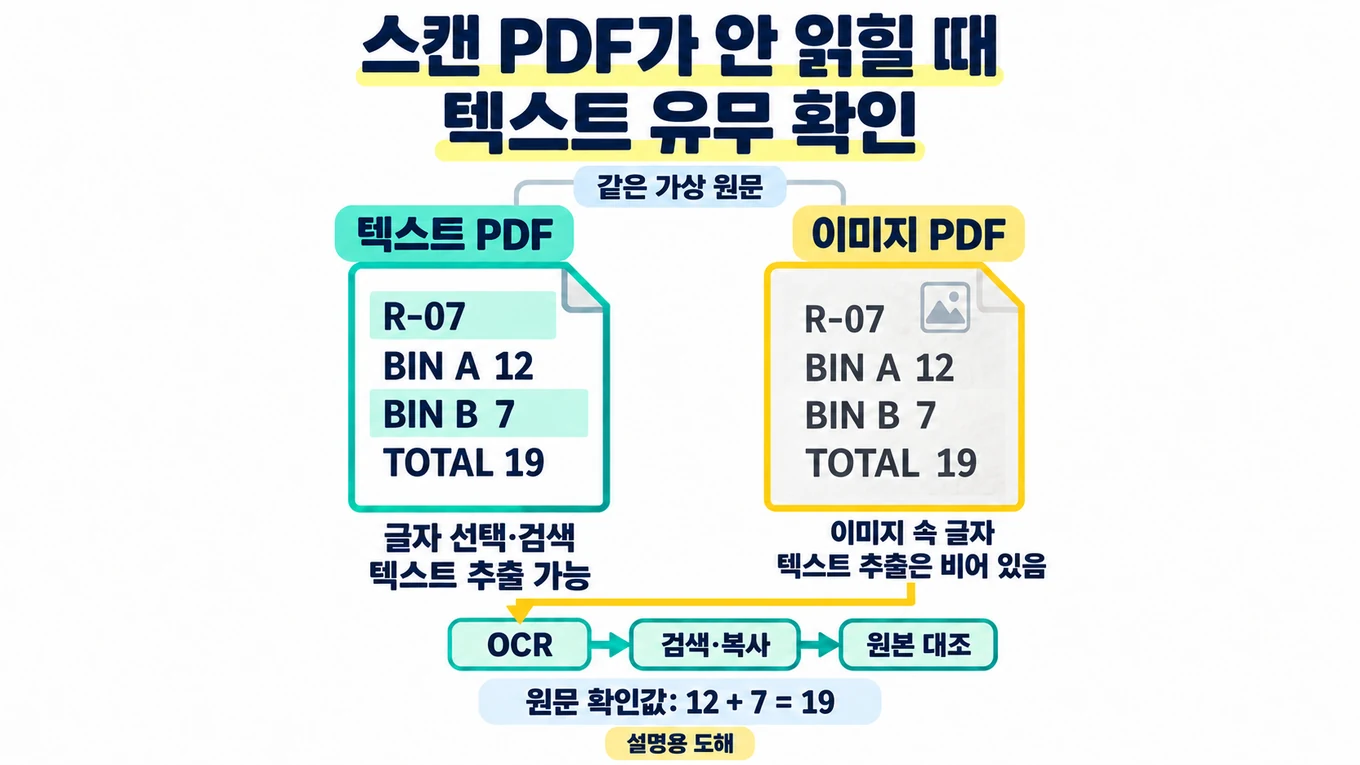
PDF가 화면에서 잘 보이는데 AI가 “내용을 찾을 수 없다”고 하거나 빈 요약을 내놓으면, 요청문을 길게 바꾸기 전에 PDF 안에 읽을 수 있는 텍스트가 있는지 확인하세요. 글자 모양을 찍은 이미지와 디지털 텍스트는 눈에는 비슷해도 처리 경로가 다릅니다.
이 글의 목표는 문서를 텍스트가 있는 PDF, 이미지 위주 PDF, 추가 확인이 필요한 PDF로 구분하고 다음 입력 경로를 고르는 것입니다. AI가 실제로 읽은 결과를 측정하는 글은 아닙니다. OCR을 했다면 글자가 생겼는지와 원문이 정확히 옮겨졌는지까지 확인해야 합니다.
먼저 AI에 다시 보내지 않고 로컬에서 확인하기
권한이 있는 PDF의 사본을 PC에서 엽니다. 원본은 그대로 보관하고 다음 두 가지를 확인하세요.
- 본문 한 줄을 드래그해 글자 단위로 선택하고 텍스트 편집기에 붙여 넣습니다
- 문서 안에 분명히 보이는 고유한 문자열을 검색합니다. 아래 가상 사례는
R-07이며, 자신의 문서에서는 눈으로 확인한 단어나 코드를 고릅니다
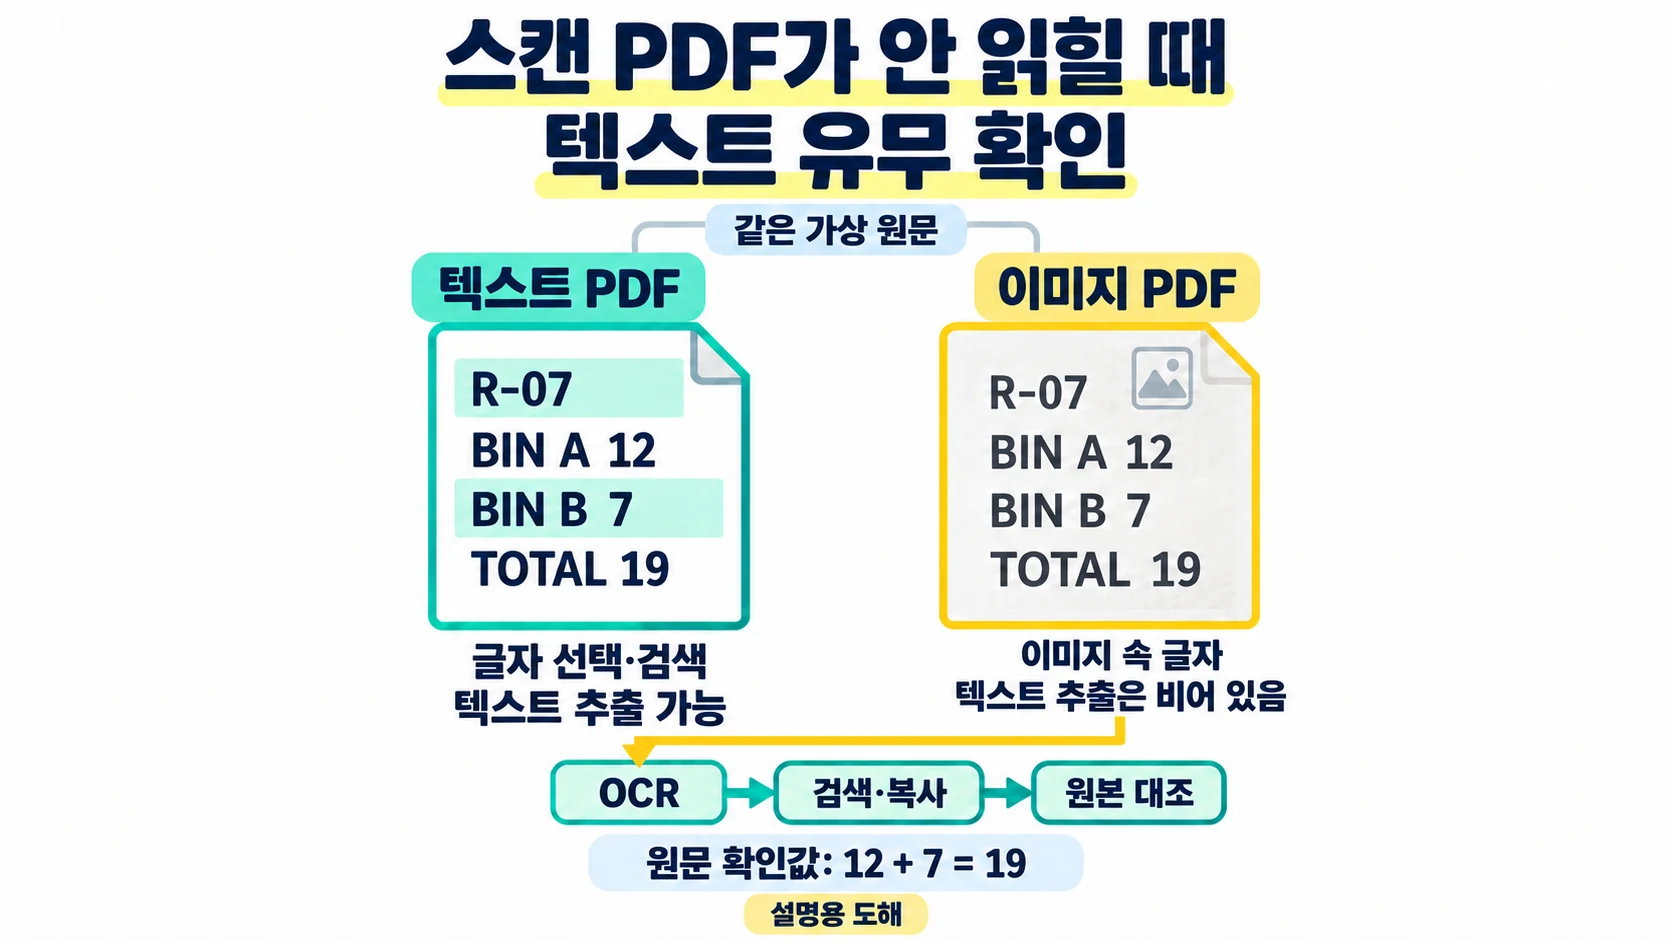
복사한 글이 실제 문장으로 붙고 검색 위치도 맞으면 텍스트를 사용할 단서가 있습니다. 페이지 전체가 한 덩어리처럼 선택되거나 본문을 복사할 수 없다면 이미지 위주 문서일 가능성을 조사합니다.
한 페이지에서 성공했다고 전체 PDF가 같은 구조인 것은 아닙니다. 앞부분은 텍스트이고 뒤의 별첨만 스캔 이미지일 수 있으므로, AI에게 맡길 페이지 범위에서 대표 페이지를 더 확인하세요. 복사가 안 된다는 사실만으로 스캔이라고 단정하지도 않습니다. 문서의 접근·복사 제한이나 텍스트 추출 문제를 확인하고, 제한된 파일은 권한 있는 원본 제공자에게 문의합니다. 보안 기능이나 문서 제한을 임의로 해제하지 않습니다.
같은 가상 페이지를 두 가지 PDF로 비교하기
예제의 원문은 가상 보관함 두 개의 수량입니다. 실제 창고·회사·사람과 무관하며 식별 기호 R-07도 가상입니다.
Inventory check
Reference: R-07
BIN A 12
BIN B 7
TOTAL 19
BIN A는 12, BIN B는 7이고 합계는 19입니다. 이 값은 원문 확인용 기대값이며 실제 AI 응답이 아닙니다. 아래 표는 이 글을 준비하면서 같은 한 페이지의 구조 차이를 로컬에서 검사한 기록입니다. 파일 이름은 그 검증에 사용한 이름이며 공개 첨부 파일을 가리키지 않습니다. 독자의 실습 대상은 자신이 열고 처리할 권한이 있는 PDF 사본입니다.
text_layer_sample.pdf: 글자를 디지털 텍스트로 저장한 PDF입니다image_only_sample.pdf: 위 페이지를 이미지로 렌더링한 뒤 그 이미지만 넣은 PDF입니다. 텍스트 층을 넣지 않았습니다
두 번째 파일은 스캔 문서와 같은 이미지 전용 구조를 만든 합성 예제입니다. 실제 종이 문서를 스캐너로 읽은 파일이나 OCR 성공 파일이 아닙니다. PDF 파일 자체를 비교할 때는 같은 내용을 가진 텍스트 PDF와 이미지 전용 PDF의 사본을 준비하면 됩니다. 위 원문만 텍스트 편집기에 복사하는 연습은 내용 대조용이며 두 종류 PDF의 구조 차이를 재현하지는 않습니다.
| 로컬에서 확인한 항목 | 텍스트 PDF | 이미지 전용 PDF |
|---|---|---|
| 페이지 수 | 1 | 1 |
| 실제 파일 크기 | 43,736바이트 | 41,687바이트 |
| 텍스트 추출 | 세 추출 도구 모두 비어 있지 않음 | 세 추출 도구 모두 본문 텍스트 없음 |
| PDF 안의 이미지 객체 | 0개 | 1개 |
| 화면에 표시되는 원문 | R-07, BIN A 12, BIN B 7, TOTAL 19 | 같은 가상 내용 |
크기는 텍스트 유무를 알려 주지 않습니다. 이 예제에서는 이미지 전용 PDF가 오히려 더 작습니다. 파일명이 .pdf인 것, 작은 파일인 것, 화면에서 글자가 선명한 것만으로 AI 입력 조건을 판단할 수 없습니다.
PDF를 실제로 만든 뒤 pypdf, pdfplumber, pdftotext로 추출 결과를 비교하고 두 파일을 PNG로 렌더링해 한 페이지씩 확인했습니다. 이 검사에서는 이미지 전용 PDF의 추출 텍스트가 비었고 텍스트 PDF에서는 원문 값이 추출됐습니다. 실제 뷰어의 선택·검색 화면이나 AI 업로드는 시험하지 않았습니다.
사용하는 AI가 PDF의 무엇을 읽는지 확인하기
일부 경로는 PDF 안의 디지털 텍스트를 추출하고, 다른 경로는 페이지의 이미지도 해석합니다. 이미지 전용 PDF를 텍스트 추출 경로에 넣었다면 내용이 비는 이유를 먼저 조사할 수 있습니다. 이때 “AI가 PDF 형식을 지원한다”와 “PDF의 그림까지 읽는다”는 별도 조건입니다.
ChatGPT의 경우 2026-10-04 KST에 확인한 공식 안내는 Enterprise의 PDF 시각 검색과 그 밖의 텍스트 기반 문서 처리를 구분합니다. 내 플랜과 업로드 위치가 해당 기능에 맞는지 확인하세요. OpenAI 파일 업로드 공식 안내
Enterprise에서도 PDF를 GPT Knowledge 또는 Project Files에 넣는 경로는 텍스트 기반으로 처리되고, 대화 중 PDF를 첨부하는 경로와 차이가 있다고 안내되어 있습니다. “같은 PDF를 올렸다”는 기록만으로 처리 조건이 같다고 판단하지 마세요. PDF 시각 검색 공식 안내
다른 AI를 사용할 때는 그 제품의 PDF·이미지 입력 안내를 확인합니다. 이 ChatGPT 조건을 다른 서비스에 그대로 적용하지 않습니다. 이미지 입력이 지원되는 경우에도 작은 가상 페이지로 먼저 확인하고, 필요한 텍스트가 정확히 반환되는지 별도로 대조하세요.
이미지 전용이면 사본에 OCR을 적용하기
OCR은 이미지의 글자 모양을 인식해 선택·검색 가능한 텍스트를 만드는 기능입니다. 사용할 수 있고 허용된 OCR 도구가 있다면 원본의 사본에 적용하세요. 웹 OCR에 회사 문서를 올리는 것을 첫 조치로 삼지 않습니다.
Adobe Acrobat의 공식 절차는 스캔 PDF를 열고 All tools → Scan & OCR → In this file에서 페이지 범위와 인식 언어를 지정한 뒤 Recognize Text를 실행하는 흐름입니다. 설치 버전·언어·이용 조건에 따라 메뉴 표시는 달라질 수 있습니다. Adobe 스캔 PDF 텍스트 인식 안내
예제처럼 영문 라벨이면 그 언어에 맞는 설정을, 한글 문서라면 한글 인식을 지원하는 설정을 확인합니다. 지원 언어와 필요한 이용 권한을 확인할 수 없다면 메뉴를 찾았다는 이유만으로 OCR이 가능하다고 기록하지 않습니다. 이 글에서는 Acrobat OCR을 실행하지 않았습니다.
처리한 사본은 새 이름으로 저장하고 다시 엽니다. 아래는 가상 원문을 대조하는 순서이며, 실제 문서에서는 해당 라벨·기호·숫자를 자신의 원문에 있는 값으로 바꾸어 검사하세요.
R-07을 검색해 해당 위치가 잡히는지 봅니다BIN A 12와BIN B 7이 있는 부분을 복사해 텍스트로 붙여 넣습니다- 두 라벨과 숫자의 연결이 원본 페이지와 같은지 확인합니다
TOTAL 19가 유지되고, 12+7=19와 맞는지 확인합니다- 확인한 페이지 범위와 아직 보지 않은 범위를 기록합니다
검색이 된다는 것은 텍스트를 사용할 수 있다는 단서입니다. 숫자·행 순서까지 정확하다는 합격 표시는 아닙니다. 인식된 글자와 원본의 보이는 글자를 대조한 뒤 AI 입력으로 사용할 범위를 정하세요.
OCR 뒤에도 틀리는 경우와 복구 방법
다음은 실제 OCR 오류 관찰이 아니라 복구 판정을 위한 가상 실패 예입니다.
| 가상 관찰 | 실패 판단 | 복구 후 확인할 것 |
|---|---|---|
| BIN A의 12를 72로 인식 | 원문 숫자 불일치 | 원본 확대 확인, 인식 조건 재검토 또는 권한 있는 사본에서 교정 후 12 유지 |
| R-07을 R-O7로 인식 | 숫자 0과 영문 O 혼동 | 원문 기호와 문자 단위 대조 |
| 12와 7이 다른 라벨에 붙음 | 표의 행 연결 손상 | 라벨·수량을 한 쌍씩 대조 |
| OCR 후에도 본문 복사·검색 안 됨 | 텍스트 사용 가능 여부 미확인 | 저장한 사본과 대상 페이지, 처리 완료 상태 확인 |
| 앞 페이지는 읽히고 별첨은 비어 있음 | 혼합 문서의 범위 누락 | 별첨까지 페이지별 확인 또는 필요한 범위만 별도 처리 |
12를 72로 읽었다면 합계가 19라는 원문과도 맞지 않습니다. AI에게 합계를 다시 설명하게 해서 해결하려 하지 말고 입력 단계의 숫자를 먼저 확인하세요. 흐림·기울어짐·잘린 글자처럼 원본 자체의 문제라면 가능할 때 더 선명한 원본을 구합니다. 내용을 모르는 사람이 OCR 숫자를 추정해 바꾸면 새 오류를 만들 수 있습니다.
AI에는 확인된 범위와 읽지 못한 범위를 함께 알려 주기
텍스트를 확인한 뒤 사용할 수 있는 요청 예는 다음과 같습니다.
다음은 가상 PDF 1페이지에서 확인한 텍스트입니다.
Reference: R-07
BIN A 12
BIN B 7
TOTAL 19

Reference와 각 BIN의 수량을 원문 그대로 정리하세요.
원문에 없는 항목은 만들지 말고, 읽지 못한 값은 '확인 필요'로 표시하세요.
두 수량의 합이 TOTAL과 같은지도 별도로 확인하세요.
기대값은 R-07, BIN A=12, BIN B=7, TOTAL=19, 합계 일치입니다. 이 예제의 값은 직접 정한 판정 기준이며 특정 모델이 반환한 결과가 아닙니다. 실제 문서는 확인된 텍스트만 전달하고, OCR이 불확실한 부분을 원문인 것처럼 숨기지 않습니다.
다음 빈 양식을 복사해 입력 상태를 남길 수 있습니다.
확인 날짜·시간대:
PDF 이름·대상 페이지 범위:
본문 한 줄 복사 결과:
고유 문자열 검색 결과:
이미지·텍스트 혼합 여부:
사용할 AI·플랜·업로드 경로:
OCR 도구·설정·처리한 사본:
원본과 대조한 라벨·숫자:
읽지 못했거나 미확인인 페이지:
다음 행동:
확인 범위와 적용 한계
공식 자료와 예제 파일 확인일은 2026-10-04 KST입니다. 두 합성 PDF의 실제 크기·텍스트 유무·렌더링은 로컬에서 검사했습니다. 실제 스캔, Acrobat OCR, ChatGPT 로그인·첨부·응답은 수행하지 않았습니다.
텍스트 추출 성공이 표 구조의 정확성이나 AI 요약의 정확성을 보장하지는 않습니다. 복잡한 다단 문서, 필기, 작은 글자, 사진 안의 표는 별도 확인이 필요합니다. 이 가이드는 먼저 입력 문서의 상태를 판단하는 절차이며, 의료·법률·회계 등 중요한 문서의 해석을 자동으로 승인하는 기준이 아닙니다.
함께 확인할 작업
파일이 아예 첨부되지 않는 상황이라면 ChatGPT 파일 첨부 오류에서 형식과 한도 구분하기를 먼저 확인하세요. 이 글의 텍스트 유무 진단은 첨부 성공 여부와 별도로 문서 안의 입력 상태를 살피는 작업입니다.
작성자 소개
